cat cases/guardiao-impacta.md
Guardião Impacta
App de conscientização em segurança da informação, feito como TCC e usado por participantes reais numa pesquisa de campo.
Resumo
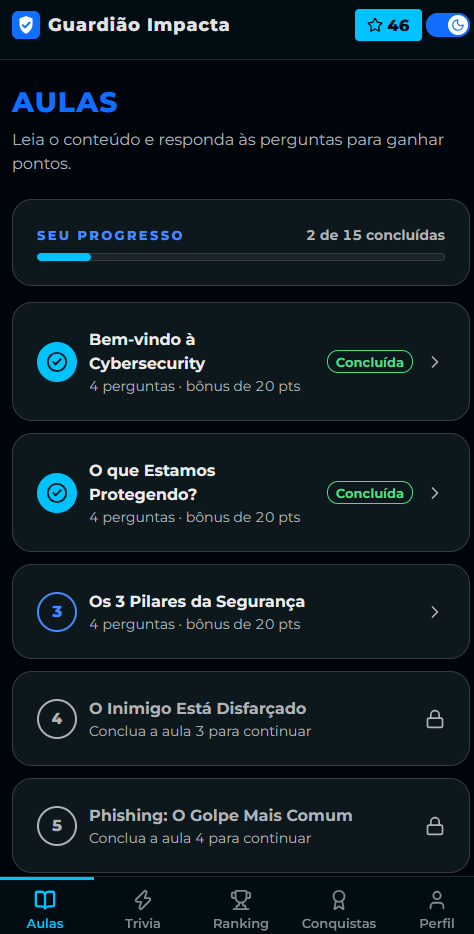
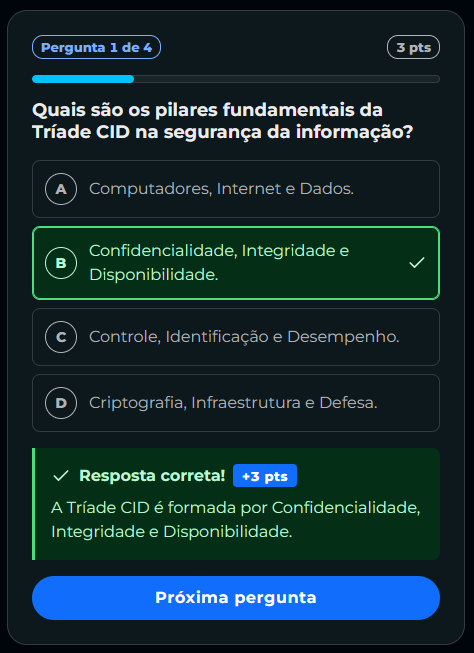
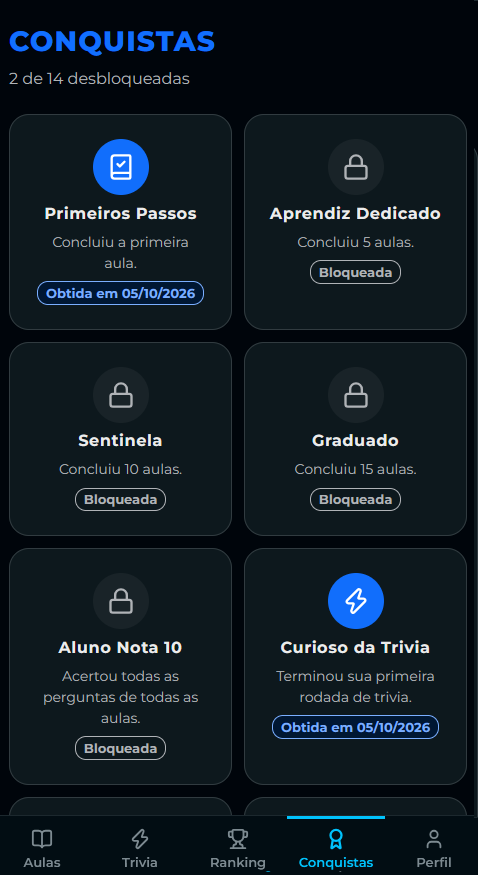
O Guardião Impacta foi um app de celular (PWA) que ensinava segurança da informação a quem não trabalha com TI, com aulas curtas, trivia, pontos, conquistas e ranking. Foi o TCC do meu grupo em Ciência da Computação e ficou em produção durante a coleta de dados da pesquisa, encerrada em 02/11/2026. Depois disso, o app foi desligado.
| Testes automatizados | 475 na API (100% das linhas) e 385 na interface (99,8%) |
| Teste de carga | 100 usuários simultâneos por 3 minutos: nenhuma falha, 95% das respostas em até 20 ms; no estresse com 1.000, até 41 ms |
| Segurança | 6 problemas achados na revisão de código e corrigidos; OWASP ZAP sem nenhuma falha depois |
| Entrega | cada push no main com a CI verde ia sozinho para produção, sem porta SSH aberta |
Contexto
Programas de conscientização em segurança costumam ter baixo engajamento, principalmente entre profissionais de áreas não técnicas. A pesquisa avaliou se um app gamificado engaja mais do que os treinamentos tradicionais que os participantes já tinham feito.
O TCC foi feito por um grupo de cinco pessoas. Minha parte foi o desenvolvimento do app inteiro (interface, API e banco), a infraestrutura, o CI/CD e a escrita da monografia. Dos 159 commits do repositório, 156 são meus.
Arquitetura
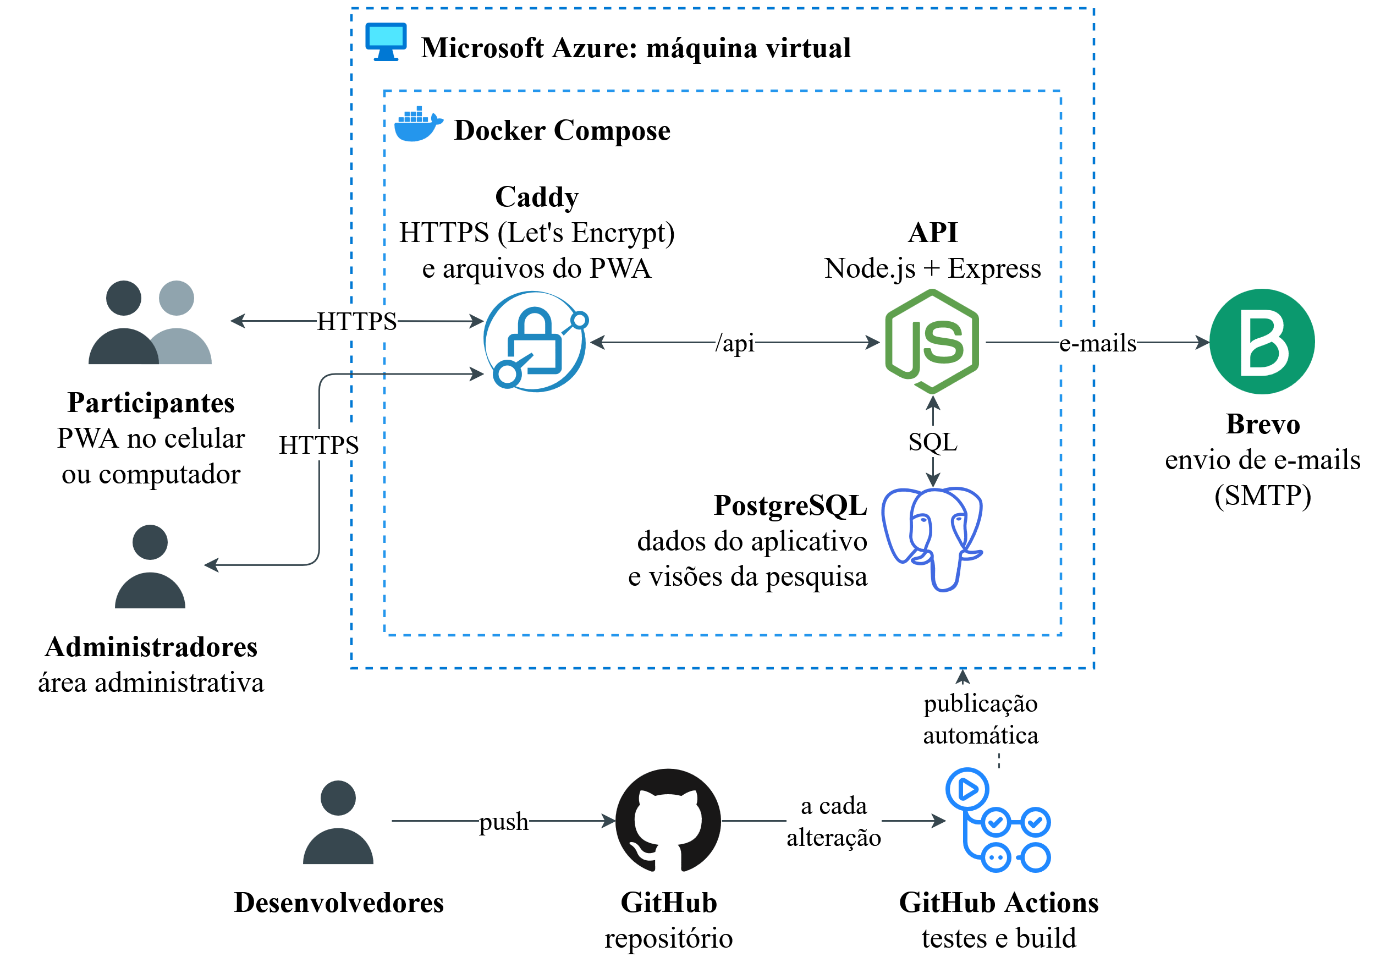
- Três contêineres numa VM Azure (Ubuntu, 2 vCPU, 8 GB), orquestrados com Docker Compose: Caddy, API e Postgres.
- O Caddy servia o PWA, emitia o certificado HTTPS e repassava
/apipara a API. Interface e API ficavam na mesma origem, então não havia CORS para configurar. - Só as portas 80 e 443 ficavam abertas. API e banco existiam só na rede interna do Compose, e o acesso administrativo era pelo Azure Bastion.
- O banco tinha backup diário.
Decisões de engenharia
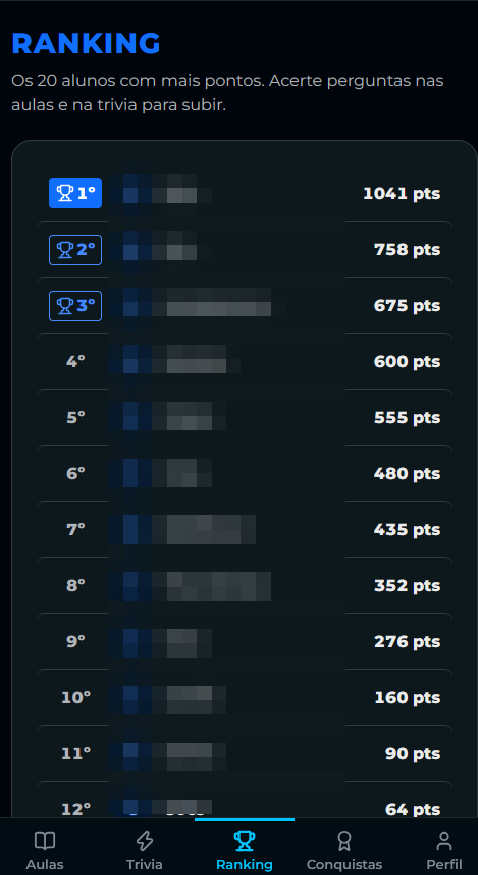
Pontuação garantida no banco, não no celular. Os pontos definiam o ranking e alimentavam os dados da pesquisa. Calculados no aparelho, poderiam ser manipulados. Por isso a regra ficou no servidor: transações com FOR UPDATE impediam que duas requisições da mesma rodada corressem em paralelo, e índices únicos parciais faziam cada questão pontuar uma única vez por pessoa, mesmo com cliques repetidos ou requisições simultâneas. Os testes de integração cobriam essas corridas.
Sessão conferida no banco a cada requisição. O token JWT só dizia quem era a pessoa; o middleware buscava o usuário no banco toda vez. Desativar uma conta ou mudar o papel dela valia na hora, e trocar a senha invalidava os tokens antigos.
Schema versionado. O banco era definido por migrations SQL numeradas, aplicadas em ordem quando a API subia. Migration já aplicada nunca era editada; toda mudança virava um arquivo novo.
Detalhes no README do projeto.
Como adicionar conteúdo
Escrever uma aula não exigia banco nem programação: cada aula era uma pasta com um arquivo HTML.
conteudo/aulas/
  16-assunto-novo/
    aula.html     título, texto e perguntas
imagens/ imagens usadas na aula- Copiar a pasta
conteudo/modelo/paraconteudo/aulas/16-assunto-novo/. O número define a ordem na trilha. - Editar o
aula.html. Cada pergunta tem 4 alternativas, uma marcada como correta, e uma explicação que aparece depois da resposta:
<div data-pergunta="pedido-de-senha" data-pontos="10">
  <p data-enunciado>Alguém liga dizendo ser do suporte e pede sua senha. O que fazer?</p>
  <ol>
    <li>Passar a senha, já que é do suporte</li>
    <li>Passar só metade da senha</li>
    <li data-correta>Recusar, desligar e reportar à segurança</li>
    <li>Pedir que mande um e-mail antes</li>
  </ol>
  <p data-explicacao>Ninguém legítimo pede sua senha. Recuse e reporte.</p>
</div>- Abrir o arquivo no navegador para ver a prévia com o visual do app.
- Rodar o validador. Se algo estiver errado, ele aponta o arquivo, a pergunta e o problema:
$ docker compose exec api npm run importar-aulas -- --validar
04-engenharia-social/aula.html: pergunta "pedido-de-senha": precisa de exatamente 1 alternativa com data-correta, tem 2- Fazer o push. A CI rodava o mesmo validador e, com tudo verde, o deploy publicava. A API importava a aula ao subir, sem perder as respostas e os pontos já dados.
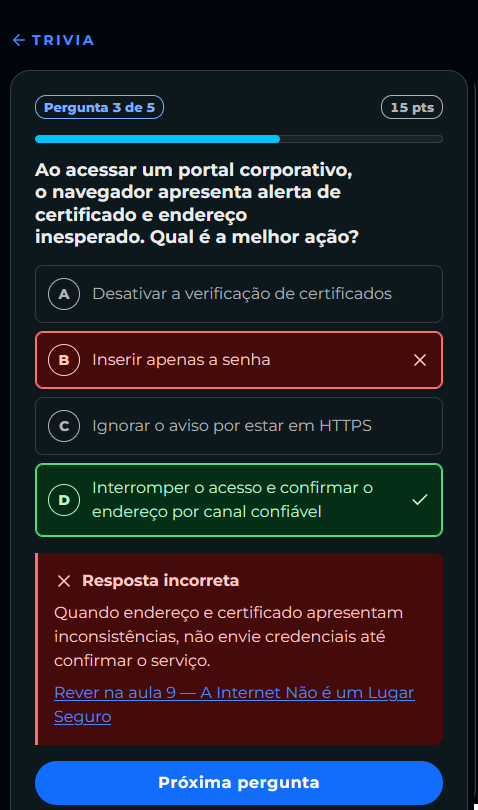
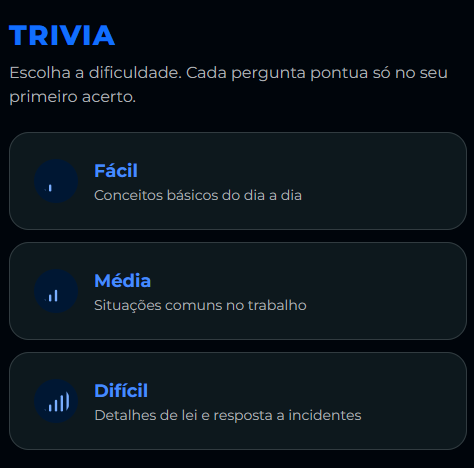
Perguntas de trivia eram cadastradas pela área de administração do app, sem código: enunciado, alternativas, explicação, nível (fácil, médio ou difícil) e a aula de referência, que virava o link “Rever na aula” quando a pessoa errava.
Com isso, o conteúdo virou arquivo versionado e testado como o código, e quem escrevia aula não precisava mexer no banco. O guia completo está em conteudo/README.md.
Entrega contínua
Cada push rodava esta sequência no GitHub Actions:
lint e formatação         eslint + prettier
caddy validate            um erro no Caddyfile derrubaria o site
aulas                     o validador da seção anterior
testes da API             contra um Postgres real, cobertura mínima de 80%
testes e build do front   cobertura mínima de 80%
deploy (só no main) login no Azure por OIDC → Run Command na VM → deploy.sh- Nenhum segredo guardado no GitHub: o login no Azure era por OIDC.
- Nenhuma porta SSH aberta: o comando chegava à VM pelo Run Command do Azure.
- Action de login fixada pelo SHA, não pela tag, porque o token desse job dava acesso de root à VM.
- Um deploy por vez, na ordem dos pushes, sem cancelar um que já tivesse começado.
- Log público enxuto: o Actions mostrava só as linhas de progresso; os logs da API ficavam na VM.
Agentes de IA sob controle
Usei o Claude Code como agente de desenvolvimento. Um agente com acesso ao terminal e à nuvem precisa de limites claros, e eles ficaram versionados no repositório:
- O que ele não podia fazer (
.claude/settings.json): ler.env, chaves e arquivos de state; fazer login no Azure ou pedir token; mexer em papéis e permissões; apagar grupo de recursos ou VM;git push --forceegit reset --hard; editar as próprias regras. - O que precisava pedir antes:
git push, deploy no Azure, comandos de VM e de rede,sshecurl. - Rede de segurança extra: um hook rodava antes de todo comando e bloqueava padrões destrutivos (
rm -rfna raiz ou na home,az group delete,terraform destroy), mesmo que escapassem das regras acima. - Escopo mínimo na nuvem: o agente usava um service principal com permissão só no grupo de recursos do TCC. O
CLAUDE.mdmandava rodarwhat-ifantes de qualquer deploy e parar se a conta ativa não fosse a desse service principal.
A monografia declara o uso de IA generativa no desenvolvimento e na revisão do texto (seção 1.6).
Qualidade e desempenho
- 475 testes na API e 385 na interface, cobrindo 100% e 99,8% das linhas. Incluíam casos de erro e de borda: acesso a dados de outro usuário (IDOR), farm de pontos, corridas de pontuação, recuperação de senha e rate limit.
- Teste de carga com k6 numa cópia da VM de produção, com usuários simulados que esperavam de 1 a 15 segundos entre um clique e outro:
- 100 usuários simultâneos por 3 minutos, metade novos (cadastro e trilha de aulas) e metade com conta: nenhuma falha, e 95% das respostas da API em até 20 ms (150 ms em login e cadastro).
- Estresse de 250 a 1.000 usuários já logados, subindo em patamares: o p95 foi de 21 ms para 41 ms. Das 59.262 requisições, só 1 falhou, barrada pelo rate limit.
- É carga sintética, não tráfego real. Com as pausas entre cliques, os 1.000 usuários geraram cerca de 146 requisições por segundo.
- Os resultados brutos não estão publicados; a rodada de 100 usuários está descrita na monografia.
Segurança
Em 01/10/2026, no meio do desenvolvimento, fiz uma rodada de segurança com o Claude Code: revisão do código da API e da interface, seguida de quatro scanners contra a stack de produção rodando localmente.
A revisão de código achou 6 problemas, todos corrigidos com testes no commit 1b8948c:
| Gravidade | Problema | Correção |
|---|---|---|
| Média | O HTML de cada aula, com o gabarito, era público e sem login | A rota passou a servir só imagens |
| Baixa-média | Um evento de telemetria começando com - virava fórmula no CSV exportado para o Excel |
Escape de tudo que começa com - e não é número |
| Baixa | Sem SMTP em produção, o link de troca de senha ia para o log | Em produção, o e-mail é descartado sem registrar o link |
| Baixa | Telemetria e trivia aceitavam 300 requisições por minuto | Limite de 60 por minuto por usuário |
| Baixa | O navegador guardava em disco as respostas da API | Cache-Control: no-store em /api |
| Baixa | O token de troca de senha ficava no histórico do navegador | O token sai da URL assim que a página abre |
Depois, os scanners:
| Ferramenta | Tipo | Resultado |
|---|---|---|
| OWASP ZAP, varredura passiva | DAST | 0 falhas, 5 avisos, 62 regras sem alerta |
| OWASP ZAP, varredura ativa | DAST | 0 falhas, 2 avisos (cabeçalhos), 139 regras sem alerta |
| Semgrep (601 regras) | SAST | 0 problemas no código; 4 alertas de configuração (Dockerfiles de desenvolvimento e actions sem SHA) |
| Trivy | dependências e imagens | 0 vulnerabilidades nas dependências do app; 19 CVEs na imagem da API, todas no npm embutido na imagem do Node |
| Gitleaks | segredos | 1 alerta, falso positivo (JWT_SECRET= vazio no .env.example) |
O npm saiu da imagem de produção da API (0dcca2d), e o Trivy passou a achar 0 CVEs nela. As CVEs da imagem do Caddy estavam no binário dele; o deploy passou a reconstruir as imagens com --pull a cada versão. A rodada também achou um bug de disponibilidade: com o banco fora do ar, a API caía em vez de responder 503. Isso foi corrigido em cb715eb.
Limites: o ZAP testou só as páginas públicas, porque não faz login sozinho. Os relatórios em HTML e JSON se perderam com a pasta temporária, e os números acima vêm do registro da sessão. Os relatórios não estão publicados; as correções estão nos commits linkados.
Pesquisa e privacidade
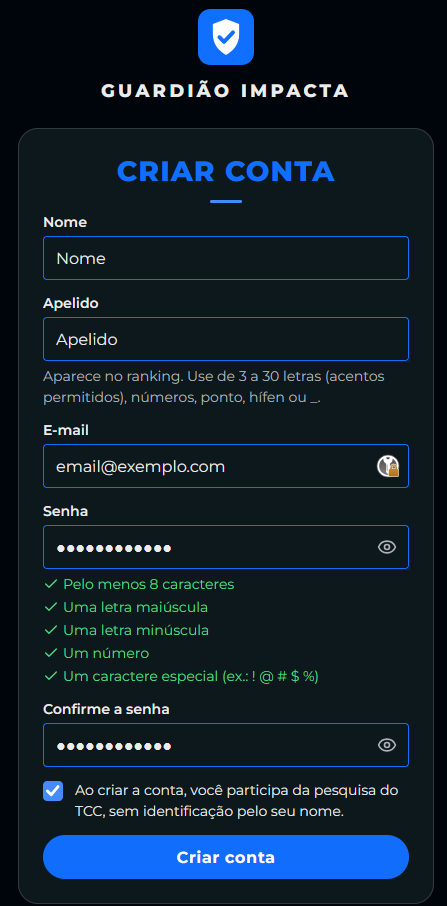
- O consentimento era obrigatório no cadastro, e contas de administração ficavam fora da pesquisa.
- Os dados eram exportados em CSV com pseudônimos, sem nome, e-mail nem apelido.
- O questionário inicial (40 itens) era obrigatório antes da primeira aula. O final (32 itens) abria 14 dias depois, com convite e lembrete por e-mail.
- Até 19/10/2026, a pesquisa tinha 26 questionários iniciais válidos.
Limites e o que eu faria diferente
- Uma VM só, sem alta disponibilidade. Para uma pesquisa com dezenas de participantes, backup diário bastava; para um produto, não bastaria.
- O script e os resultados do k6 ficaram fora do Git. Hoje eu versionaria os dois junto com o código.
- O README ficou atrás da monografia nas contagens de testes.
- A pesquisa não teve grupo de controle: o resultado mostra associação, não causa.
Telas
Links
- Código: github.com/osamufelix/guardiao-impacta
- Monografia (PDF): Gamificação em security awareness